DISPATCH №0825 / 2026-08-25 / MORNING EDITION / 08 ITEMS / BUILD 20260825.0737 / LIVE / CURATED BY 泉水亮介
VCB News & Post Headline
JST · 07:37 · MON
MORNING DISPATCH · MONDAY · AUGUST 25, 2026

2026.08.25

NVIDIA · Anthropic · OpenAI · Claude 08 ITEMS · READ 6 min
AIインフラ / NVIDIA NEWSROOM / CNBC / NEWS

NVIDIA、推論専用チップ「Groq 3 LPX」が量産開始 — Gemma 4 31B で毎秒3,400トークン
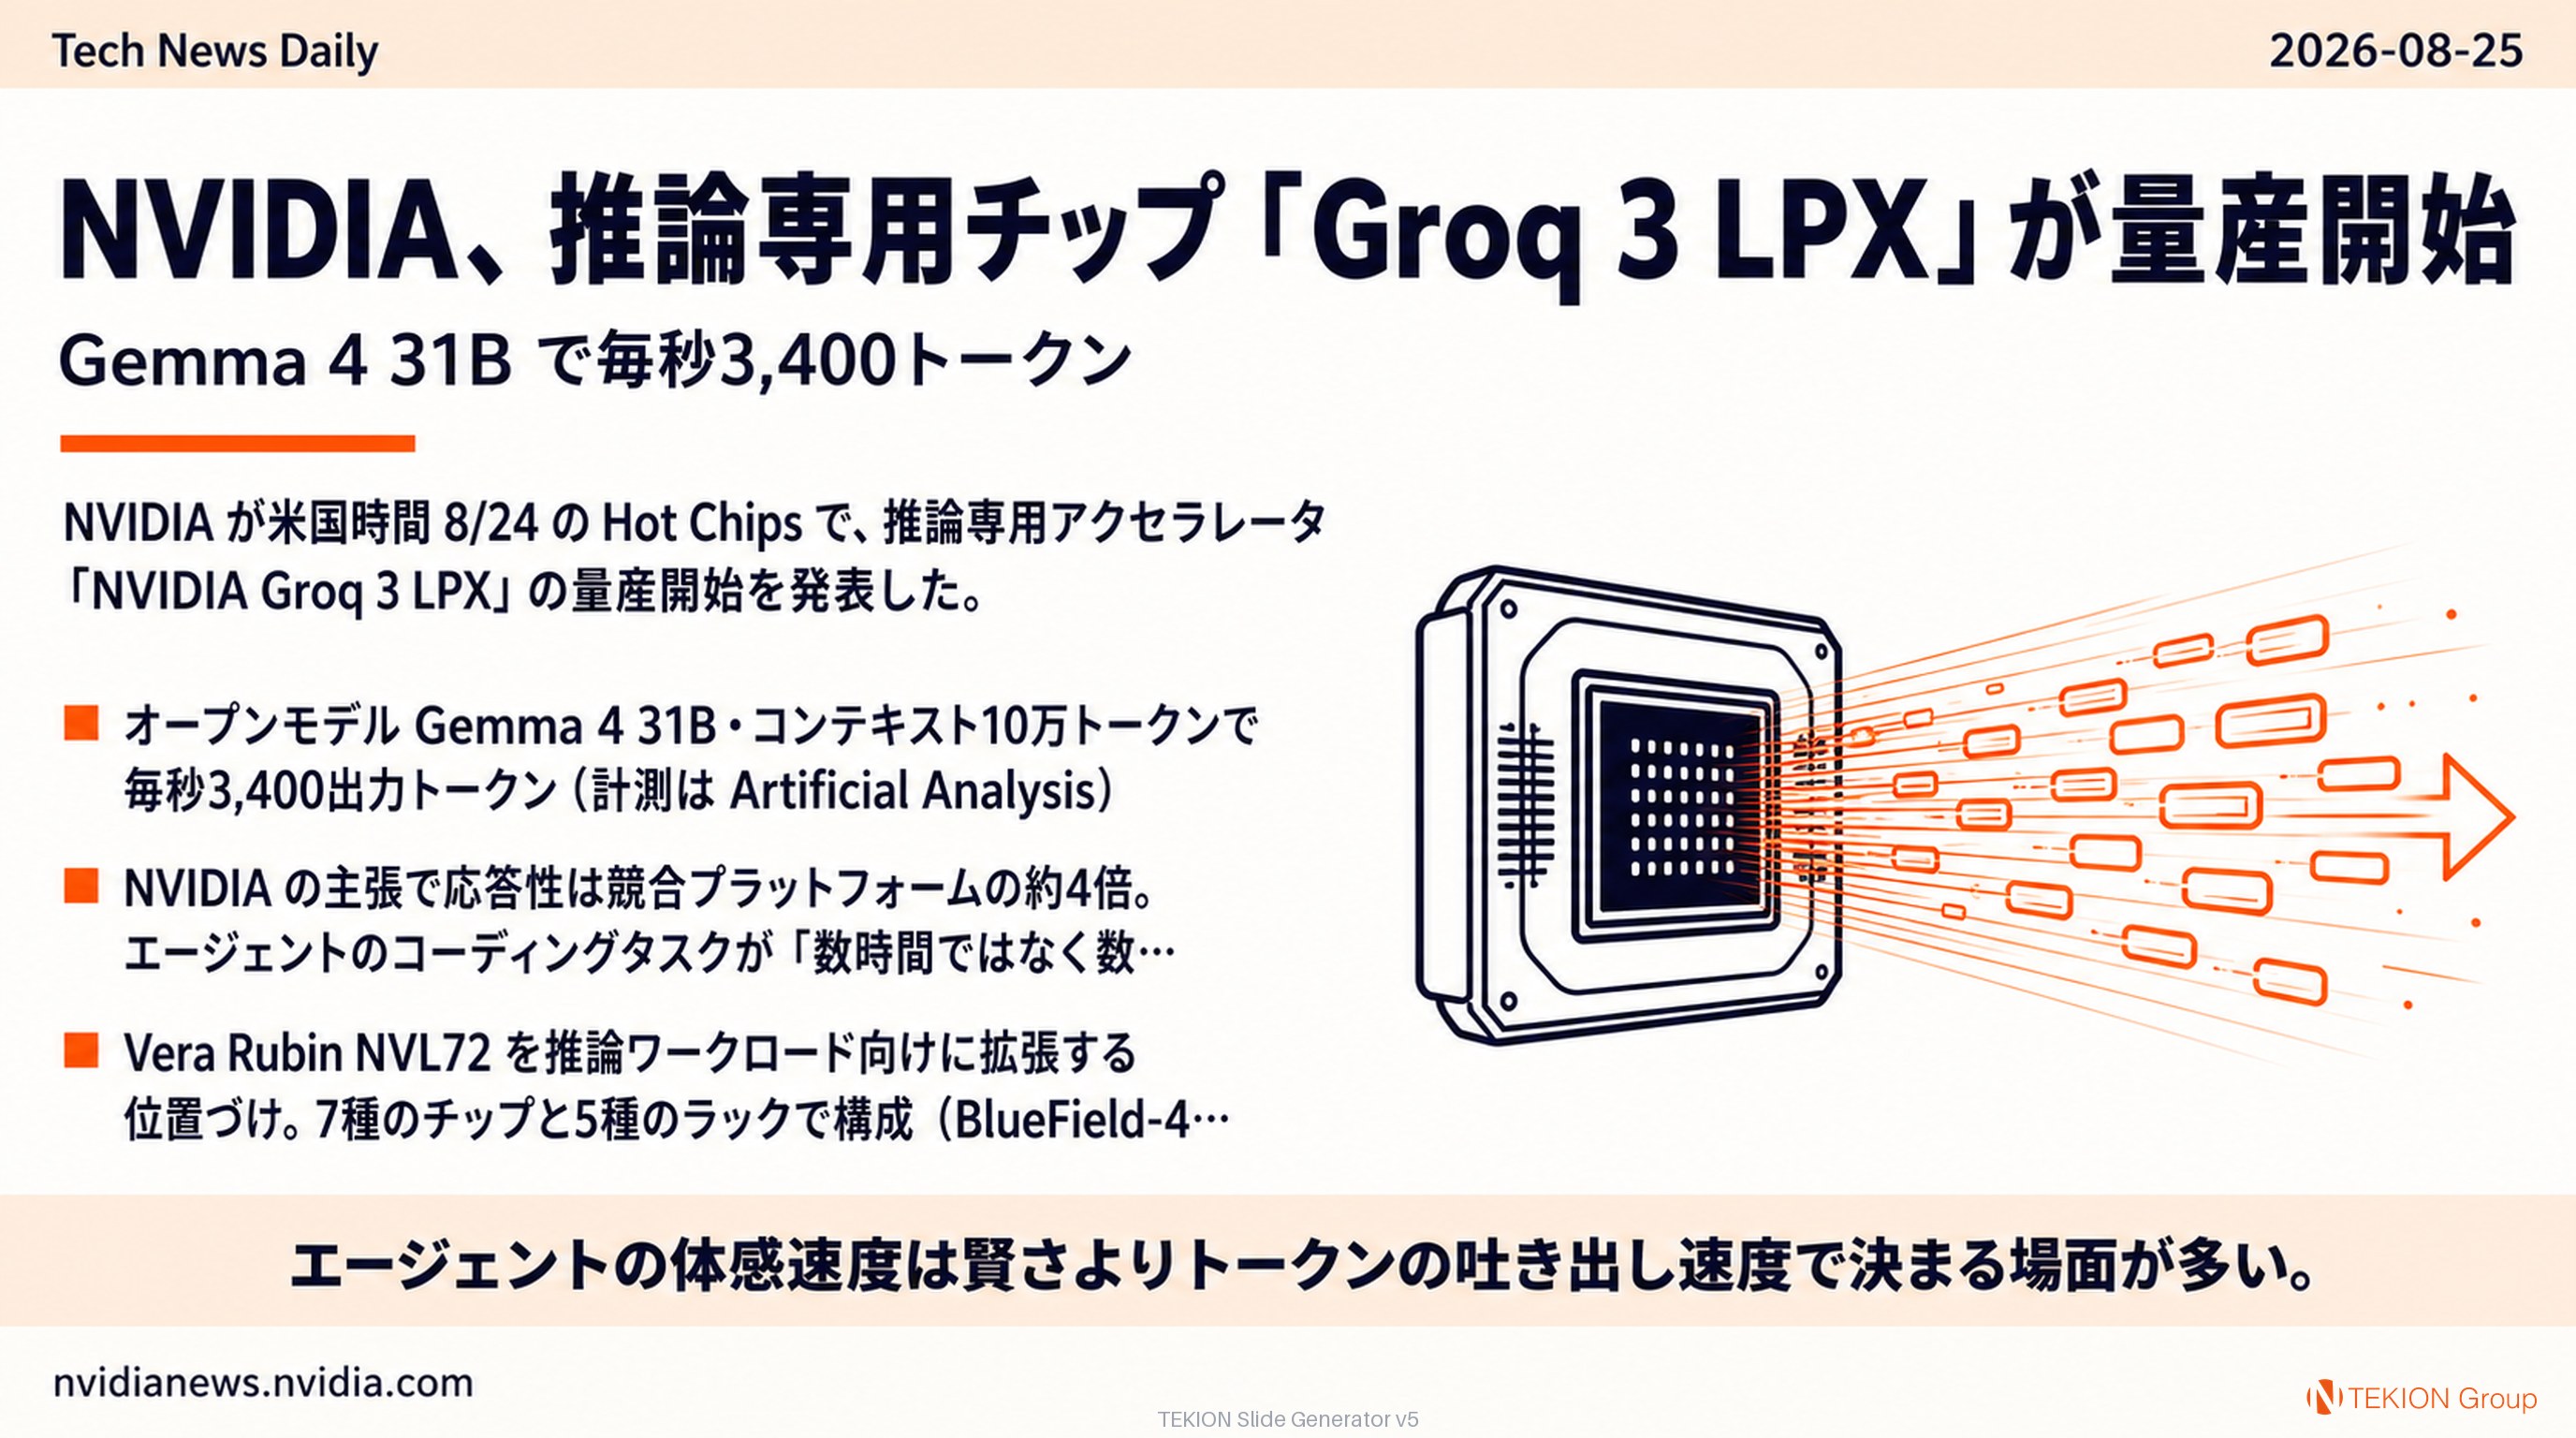
NVIDIA、推論専用チップ「Groq 3 LPX」が量産開始 — Gemma 4 31B で毎秒3,400トークン

NVIDIA が米国時間 8/24 の Hot Chips で、推論専用アクセラレータ「NVIDIA Groq 3 LPX」の量産開始を発表した。昨年12月に約200億ドルで買収した Groq の資産をベースにした製品で、トークンを1つずつ吐き出すデコード段だけを速くすることに振り切っている。Vera Rubin NVL72 の構成に組み込む形で提供され、最初の採用先は AI クラウドの Nebius。

キーポイント

  • オープンモデル Gemma 4 31B・コンテキスト10万トークンで毎秒3,400出力トークン(計測は Artificial Analysis)
  • NVIDIA の主張で応答性は競合プラットフォームの約4倍。エージェントのコーディングタスクが「数時間ではなく数分」で終わる水準
  • Vera Rubin NVL72 を推論ワークロード向けに拡張する位置づけ。7種のチップと5種のラックで構成(BlueField-4 DPU・Vera CPU ラック・Spectrum-6 SPX Ethernet ほか)
  • 買収額は約200億ドル(2025年12月)。Tom's Hardware によると製造は Samsung、ダイ上に 500MB の SRAM を載せてメモリ帯域のボトルネックを回避する設計
  • 最初の採用は AI クラウドの Nebius。Nebius Token Factory へ統合し年内オンライン。Groq 自身の推論クラウドも早期導入を予定
  • Jensen Huang「Vera Rubin はエージェンティック AI の時代に向けたワークロード最適化構成。LPX が超高速なトークン生成で性能フロンティアを押し上げる」
エージェントの体感速度は賢さよりトークンの吐き出し速度で決まる場面が多い。ループを何十周も回す使い方だと、1周あたりの待ち時間がそのまま1日の処理量になる。推論専用ハードが量産に入ったのは、来年以降の運用コストと速度の前提が変わる合図。
AI開発ツール / ANTHROPIC 公式ブログ / NEWS

Anthropic、MCPコネクタの「会社まとめて認可」が正式提供に

Anthropic、MCPコネクタの「会社まとめて認可」が正式提供に

Claude の Team / Enterprise プランで、MCP コネクタの認可を IT 管理者が ID プロバイダ側で一括設定できる enterprise-managed auth が 8/24 に正式提供(GA)になった。これまでは「管理者が組織でコネクタを有効化する」「各ユーザーが自分で OAuth 認可する」の2段階が必要で、後半の個別認可が現場の詰まりどころだった。管理者が Okta で一度設定すれば、社員は初回ログイン時に権限を自動で引き継ぐ。

キーポイント

  • MCP の Enterprise-Managed Authorization (EMA) 拡張の最初の実装。EMA 自体は 6/18 に MCP 側で stable になっていた
  • 対応コネクタに Datadog・Notion・Slack が追加。既存対応は Asana・Atlassian・Canva・Figma・Granola・Linear・Supabase。Exa・Miro・Zoom は近日対応
  • ID プロバイダは現時点で Okta のみ(他社対応は近日)
  • Claude チャット・Claude Code・Cowork をまたいでアクセス権が一貫する
  • 対象は Claude Team / Enterprise プラン。ヘルプセンターから access を申請する
  • Supabase も同日、自社 MCP サーバーの enterprise-managed auth 対応を Anthropic・Okta と共同で告知
社内に AI エージェントを配るとき実際に止まるのは技術ではなく「全員に個別認可させる」運用のところ。そこが ID プロバイダ側に寄ると配る側の負担が消える。裏を返せば、誰がどのツールに触れるかの権限設計を情シス側で先に決めておく必要が出てくる。
AI開発ツール / OPENAI DEVELOPERS / NEWS

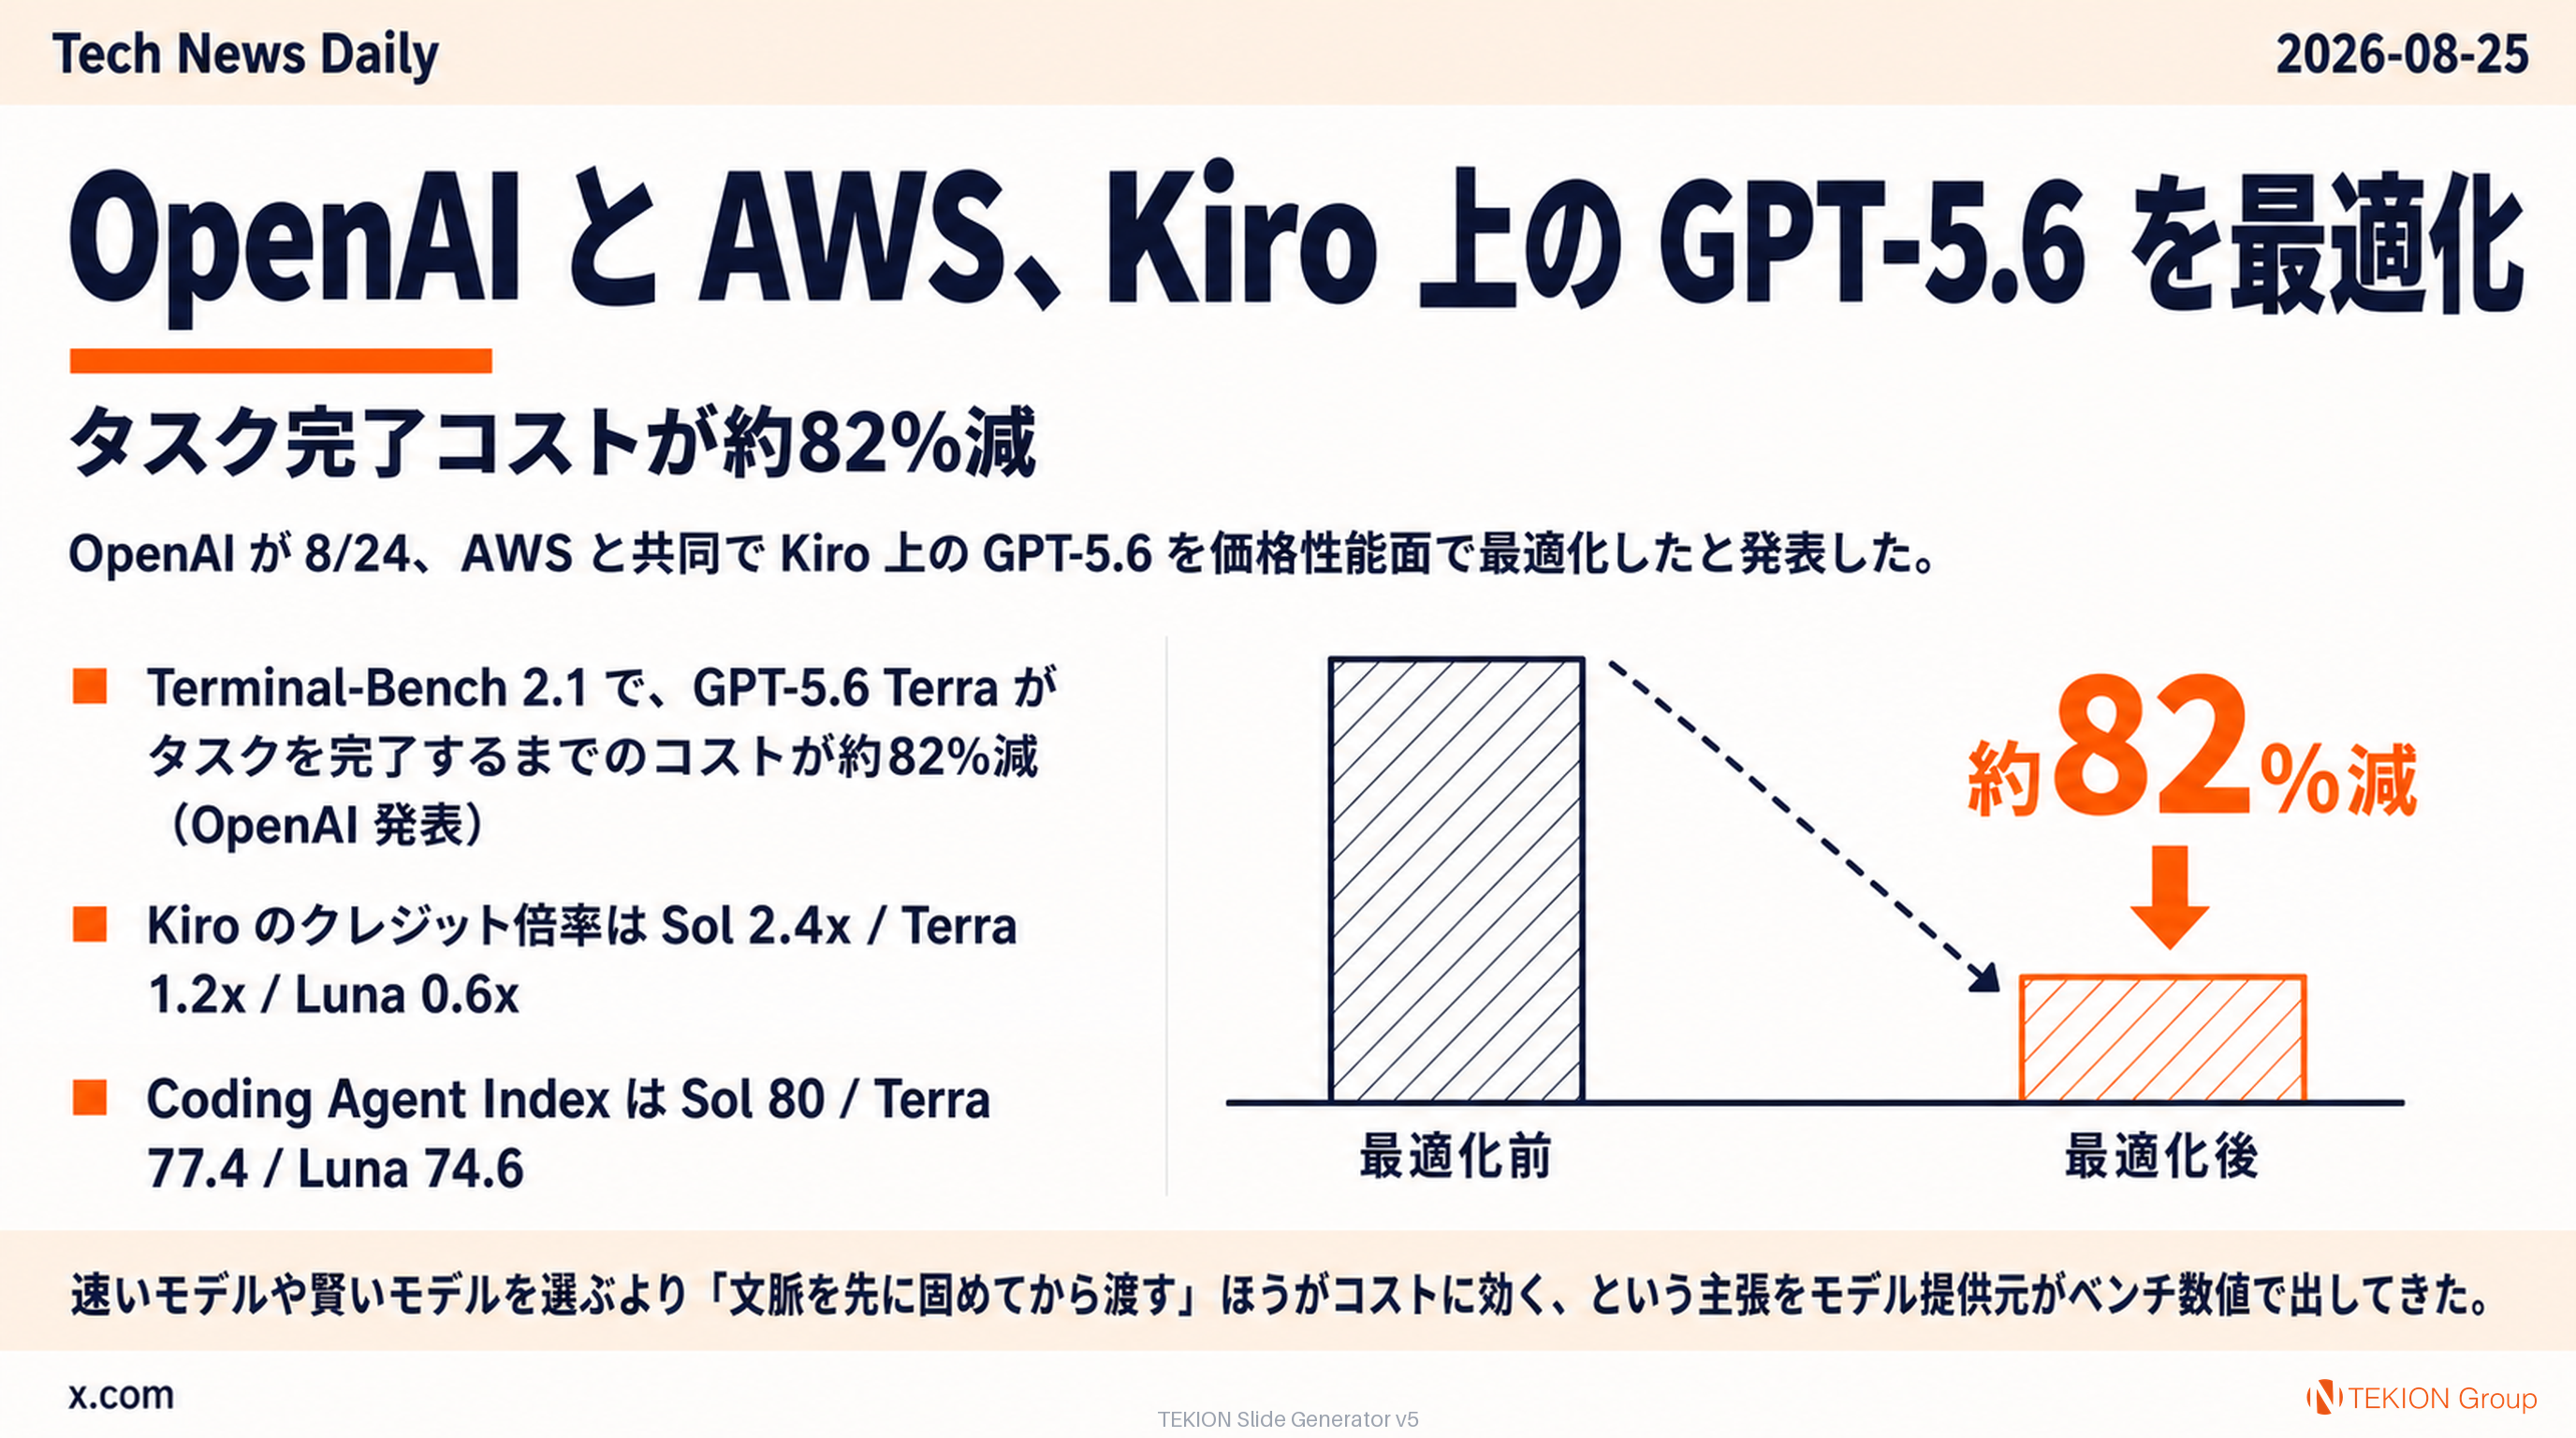
OpenAI と AWS、Kiro 上の GPT-5.6 を最適化 — タスク完了コストが約82%減

OpenAI と AWS、Kiro 上の GPT-5.6 を最適化 — タスク完了コストが約82%減

OpenAI が 8/24、AWS と共同で Kiro 上の GPT-5.6 を価格性能面で最適化したと発表した。要件・技術設計・タスク文脈を先に固めてからモデルに渡す Kiro の spec-driven なやり方と組み合わせることで、同じ作業を終えるまでのコストが下がったという内容。GPT-5.6 の Sol / Terra / Luna が Kiro の IDE・CLI・Web で使える。

キーポイント

  • Terminal-Bench 2.1 で、GPT-5.6 Terra がタスクを完了するまでのコストが約82%減(OpenAI 発表)
  • Kiro のクレジット倍率は Sol 2.4x / Terra 1.2x / Luna 0.6x
  • Coding Agent Index は Sol 80 / Terra 77.4 / Luna 74.6
  • Terminal-Bench 2.1 のスコアは Sol 88.8% / Terra 87.4% / Luna 84.7%
  • 提供リージョンは AWS US-East-1(北バージニア)と AWS Europe(フランクフルト)。クロスリージョン推論に対応
  • あわせて GPT-5.6 Luna の価格が80%減、Terra が20%減
速いモデルや賢いモデルを選ぶより「文脈を先に固めてから渡す」ほうがコストに効く、という主張をモデル提供元がベンチ数値で出してきた。仕様を書いてから作らせる進め方が料金明細に出るという話になっている。
AI開発ツール / CLAUDEDEVS(ANTHROPIC 公式) / NEWS

Claude の Web・デスクトップ、長文の描画を作り直して約4倍なめらかに

Claude の Web・デスクトップ、長文の描画を作り直して約4倍なめらかに

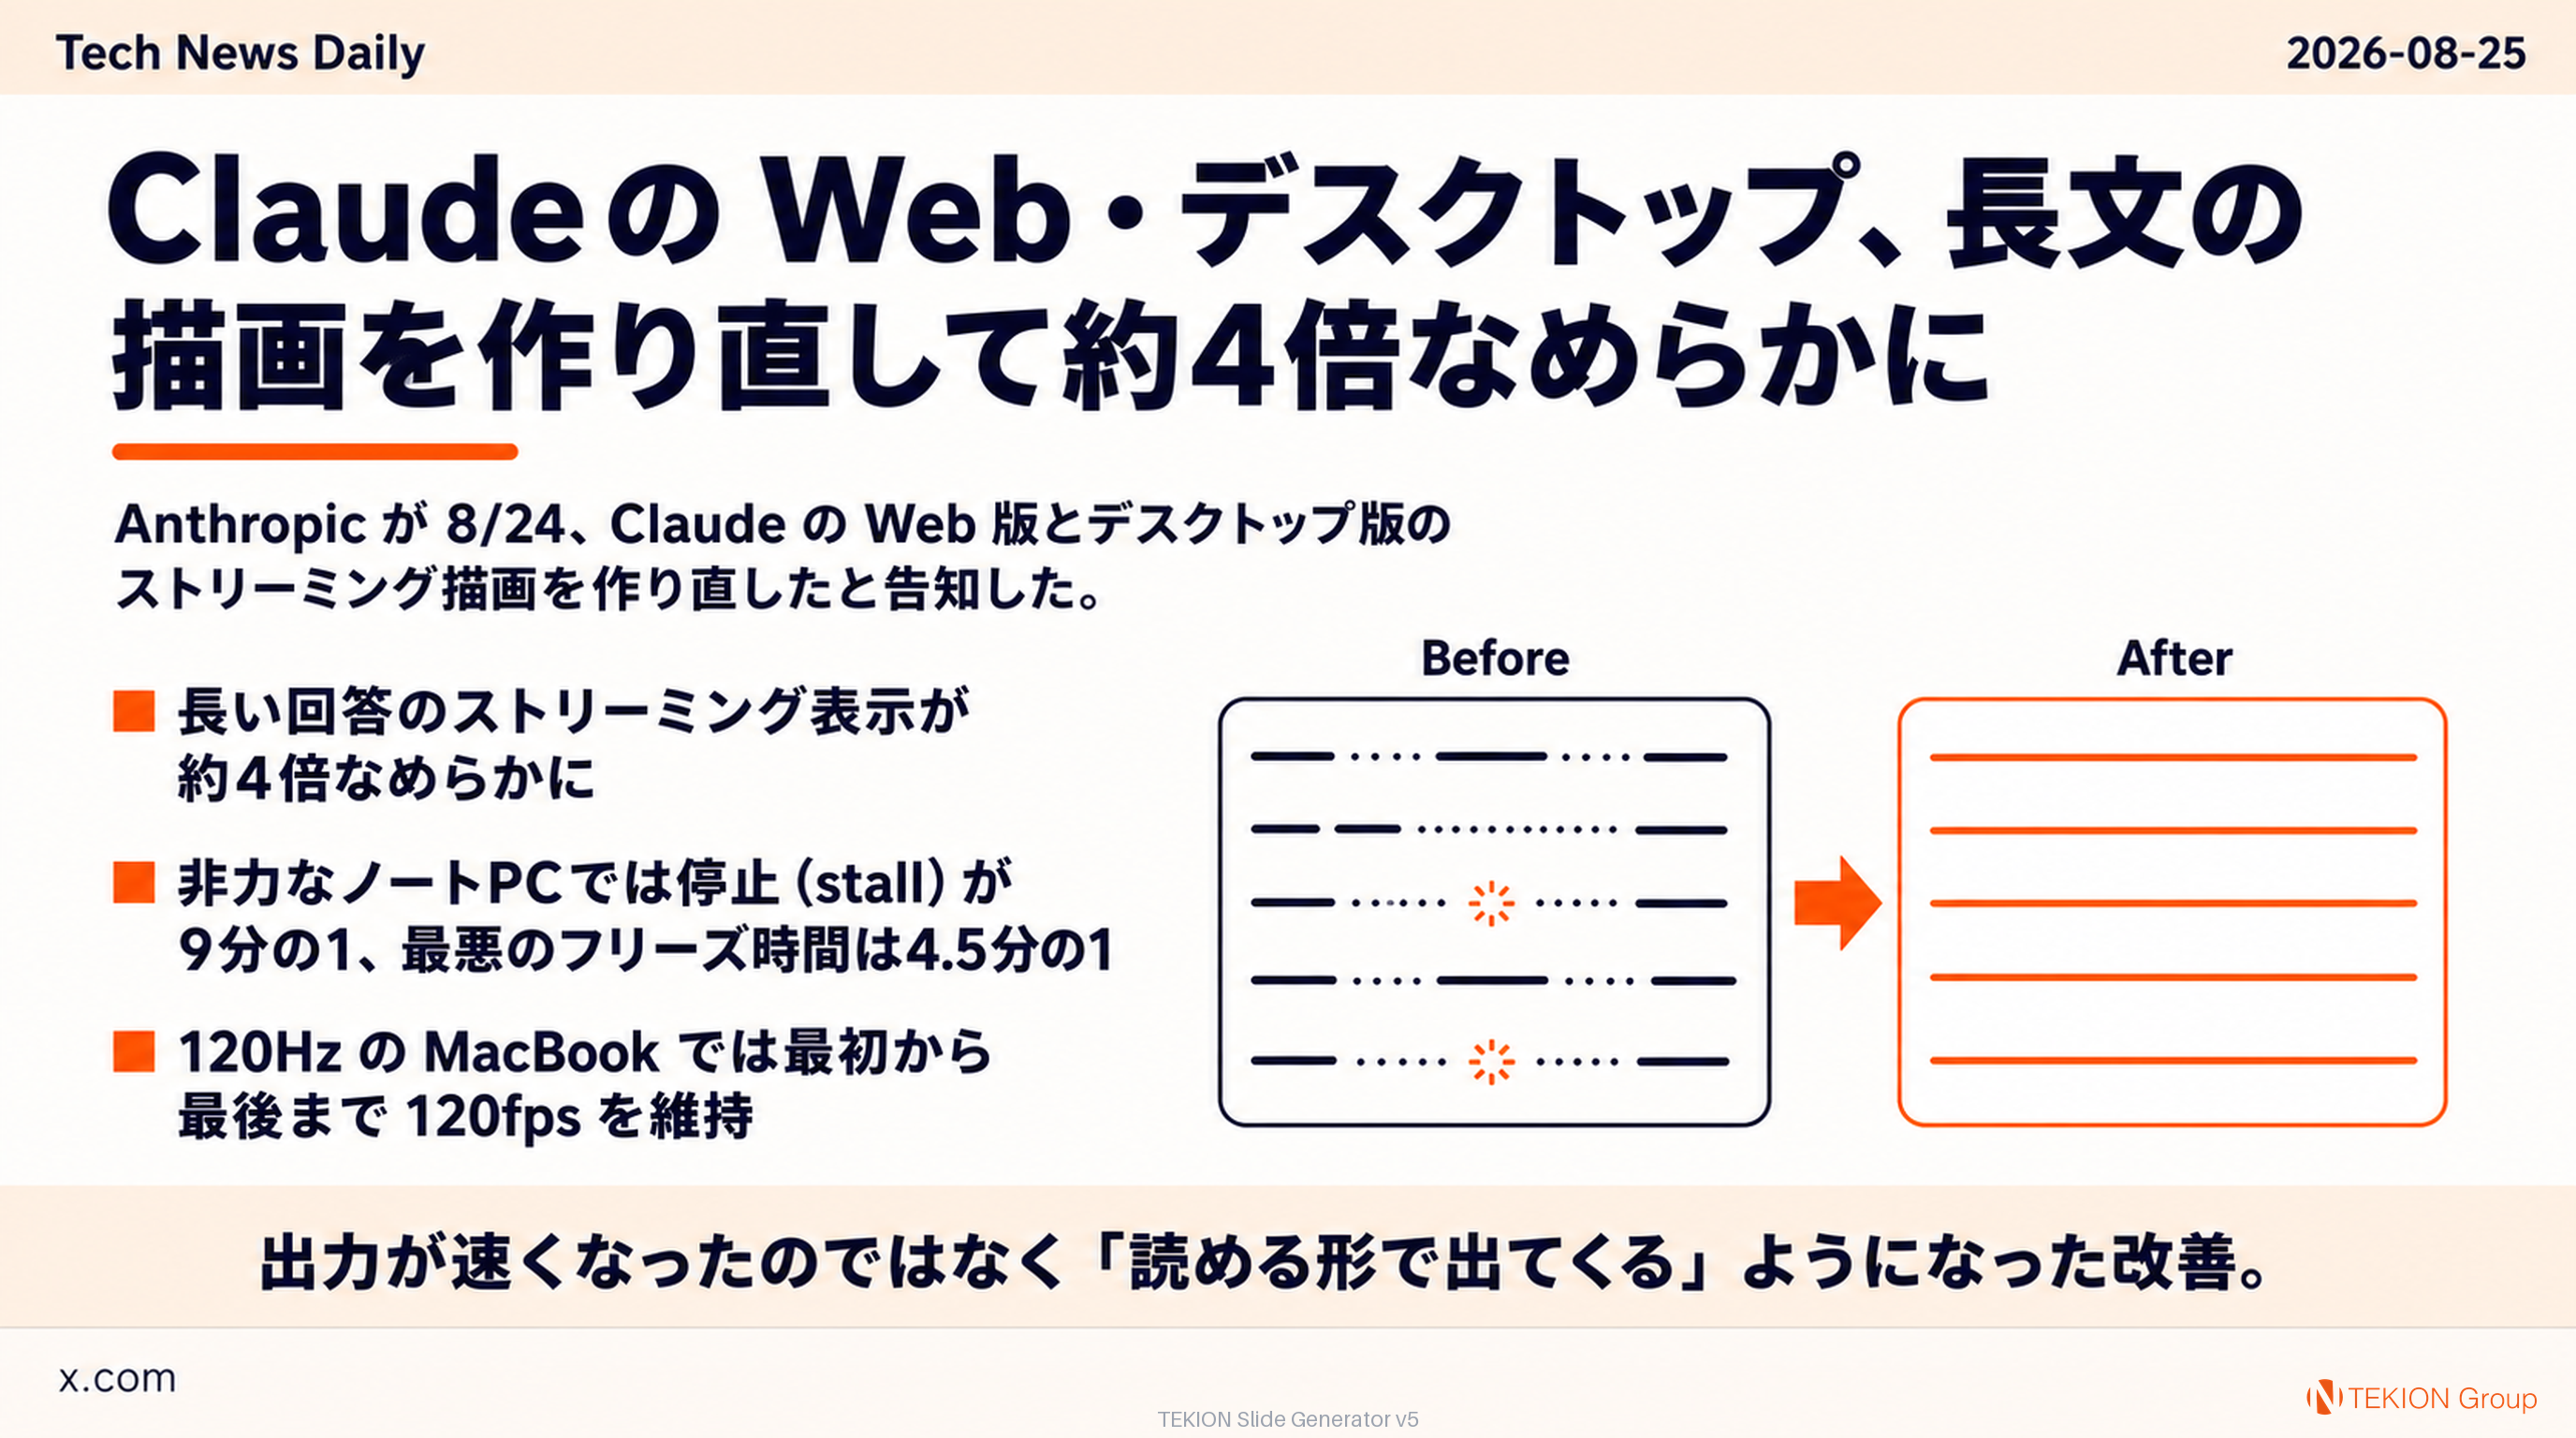
Anthropic が 8/24、Claude の Web 版とデスクトップ版のストリーミング描画を作り直したと告知した。返答全体を毎フレーム描き直すのをやめ、まだ変化している箇所だけを更新する方式に変えたことで、長い回答の表示が体感で約4倍なめらかになったという。モデル自体は変わっていない。

キーポイント

  • 長い回答のストリーミング表示が約4倍なめらかに
  • 非力なノートPCでは停止(stall)が9分の1、最悪のフリーズ時間は4.5分の1
  • 120Hz の MacBook では最初から最後まで 120fps を維持
  • 変更したのはレンダラーのみ。「まだ変化している箇所だけを触る」設計に置き換えた
  • モデルの速度や品質は変わっていない
出力が速くなったのではなく「読める形で出てくる」ようになった改善。調査・設計・レビューのように長文を返させる使い方ほど効く。地味だが AI を一日中開いている人ほど体感差が大きい。
AI開発ツール / THIBAULT SOTTIAUX(OPENAI / CODEX) / NEWS

Codex の利用枠が急に減る問題、原因3つを特定して修正

Codex の利用枠が急に減る問題、原因3つを特定して修正

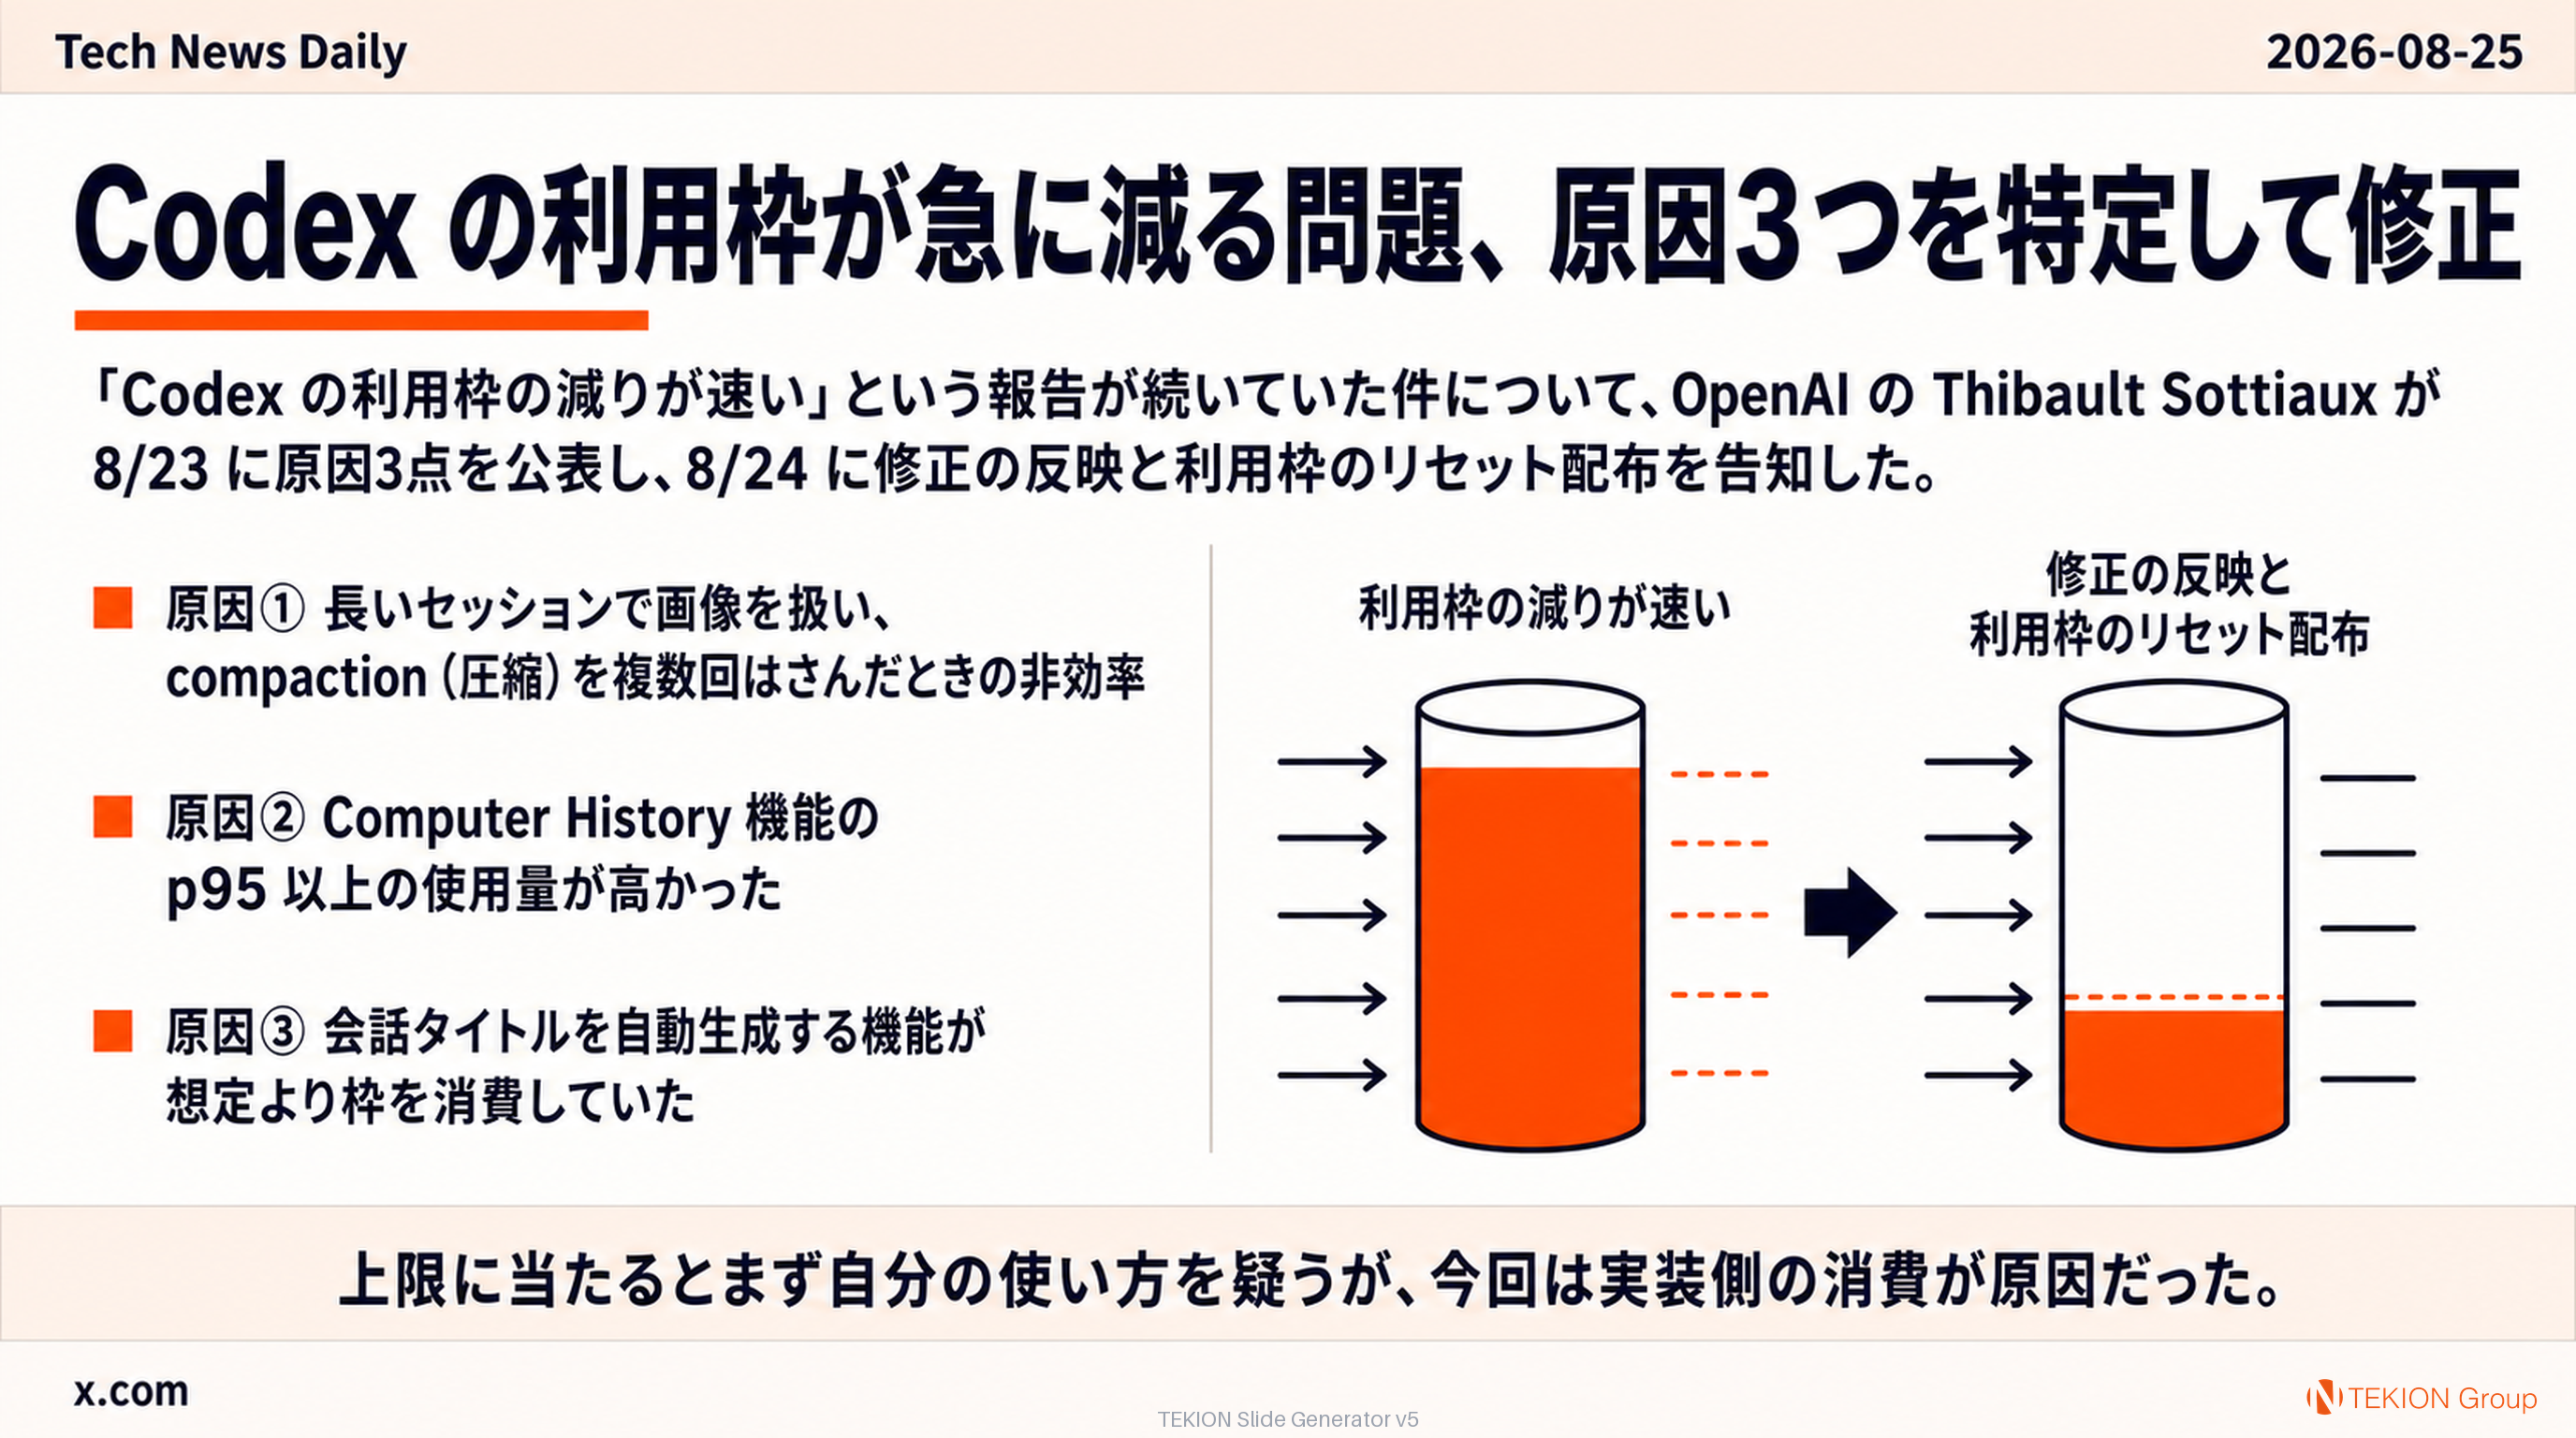
「Codex の利用枠の減りが速い」という報告が続いていた件について、OpenAI の Thibault Sottiaux が 8/23 に原因3点を公表し、8/24 に修正の反映と利用枠のリセット配布を告知した。ユーザーの使い方ではなく実装側の非効率が原因だったという説明になっている。

キーポイント

  • 原因① 長いセッションで画像を扱い、compaction(圧縮)を複数回はさんだときの非効率
  • 原因② Computer History 機能の p95 以上の使用量が高かった
  • 原因③ 会話タイトルを自動生成する機能が想定より枠を消費していた
  • タイガーチームを編成して翌日に修正を出荷。利用枠のリセットは 8/24 14:00 PST 前後に反映
  • 別途「効率を大幅に上げる新しい手法」を見つけたとして翌週に着手予定と予告
上限に当たるとまず自分の使い方を疑うが、今回は実装側の消費が原因だった。エージェントを長時間回す運用では、画像・履歴機能・自動生成タイトルのような裏で動くものが枠を食う。自分のループでも意図せず毎周回で消えている入力がないか見直す材料になる。
ローカルLLM / LEVEL1TECHS FORUMS / @STEEVE / NEWS

〈知見〉ローカルLLMが「バカに感じる」のはモデルのせいではない

〈知見〉ローカルLLMが「バカに感じる」のはモデルのせいではない

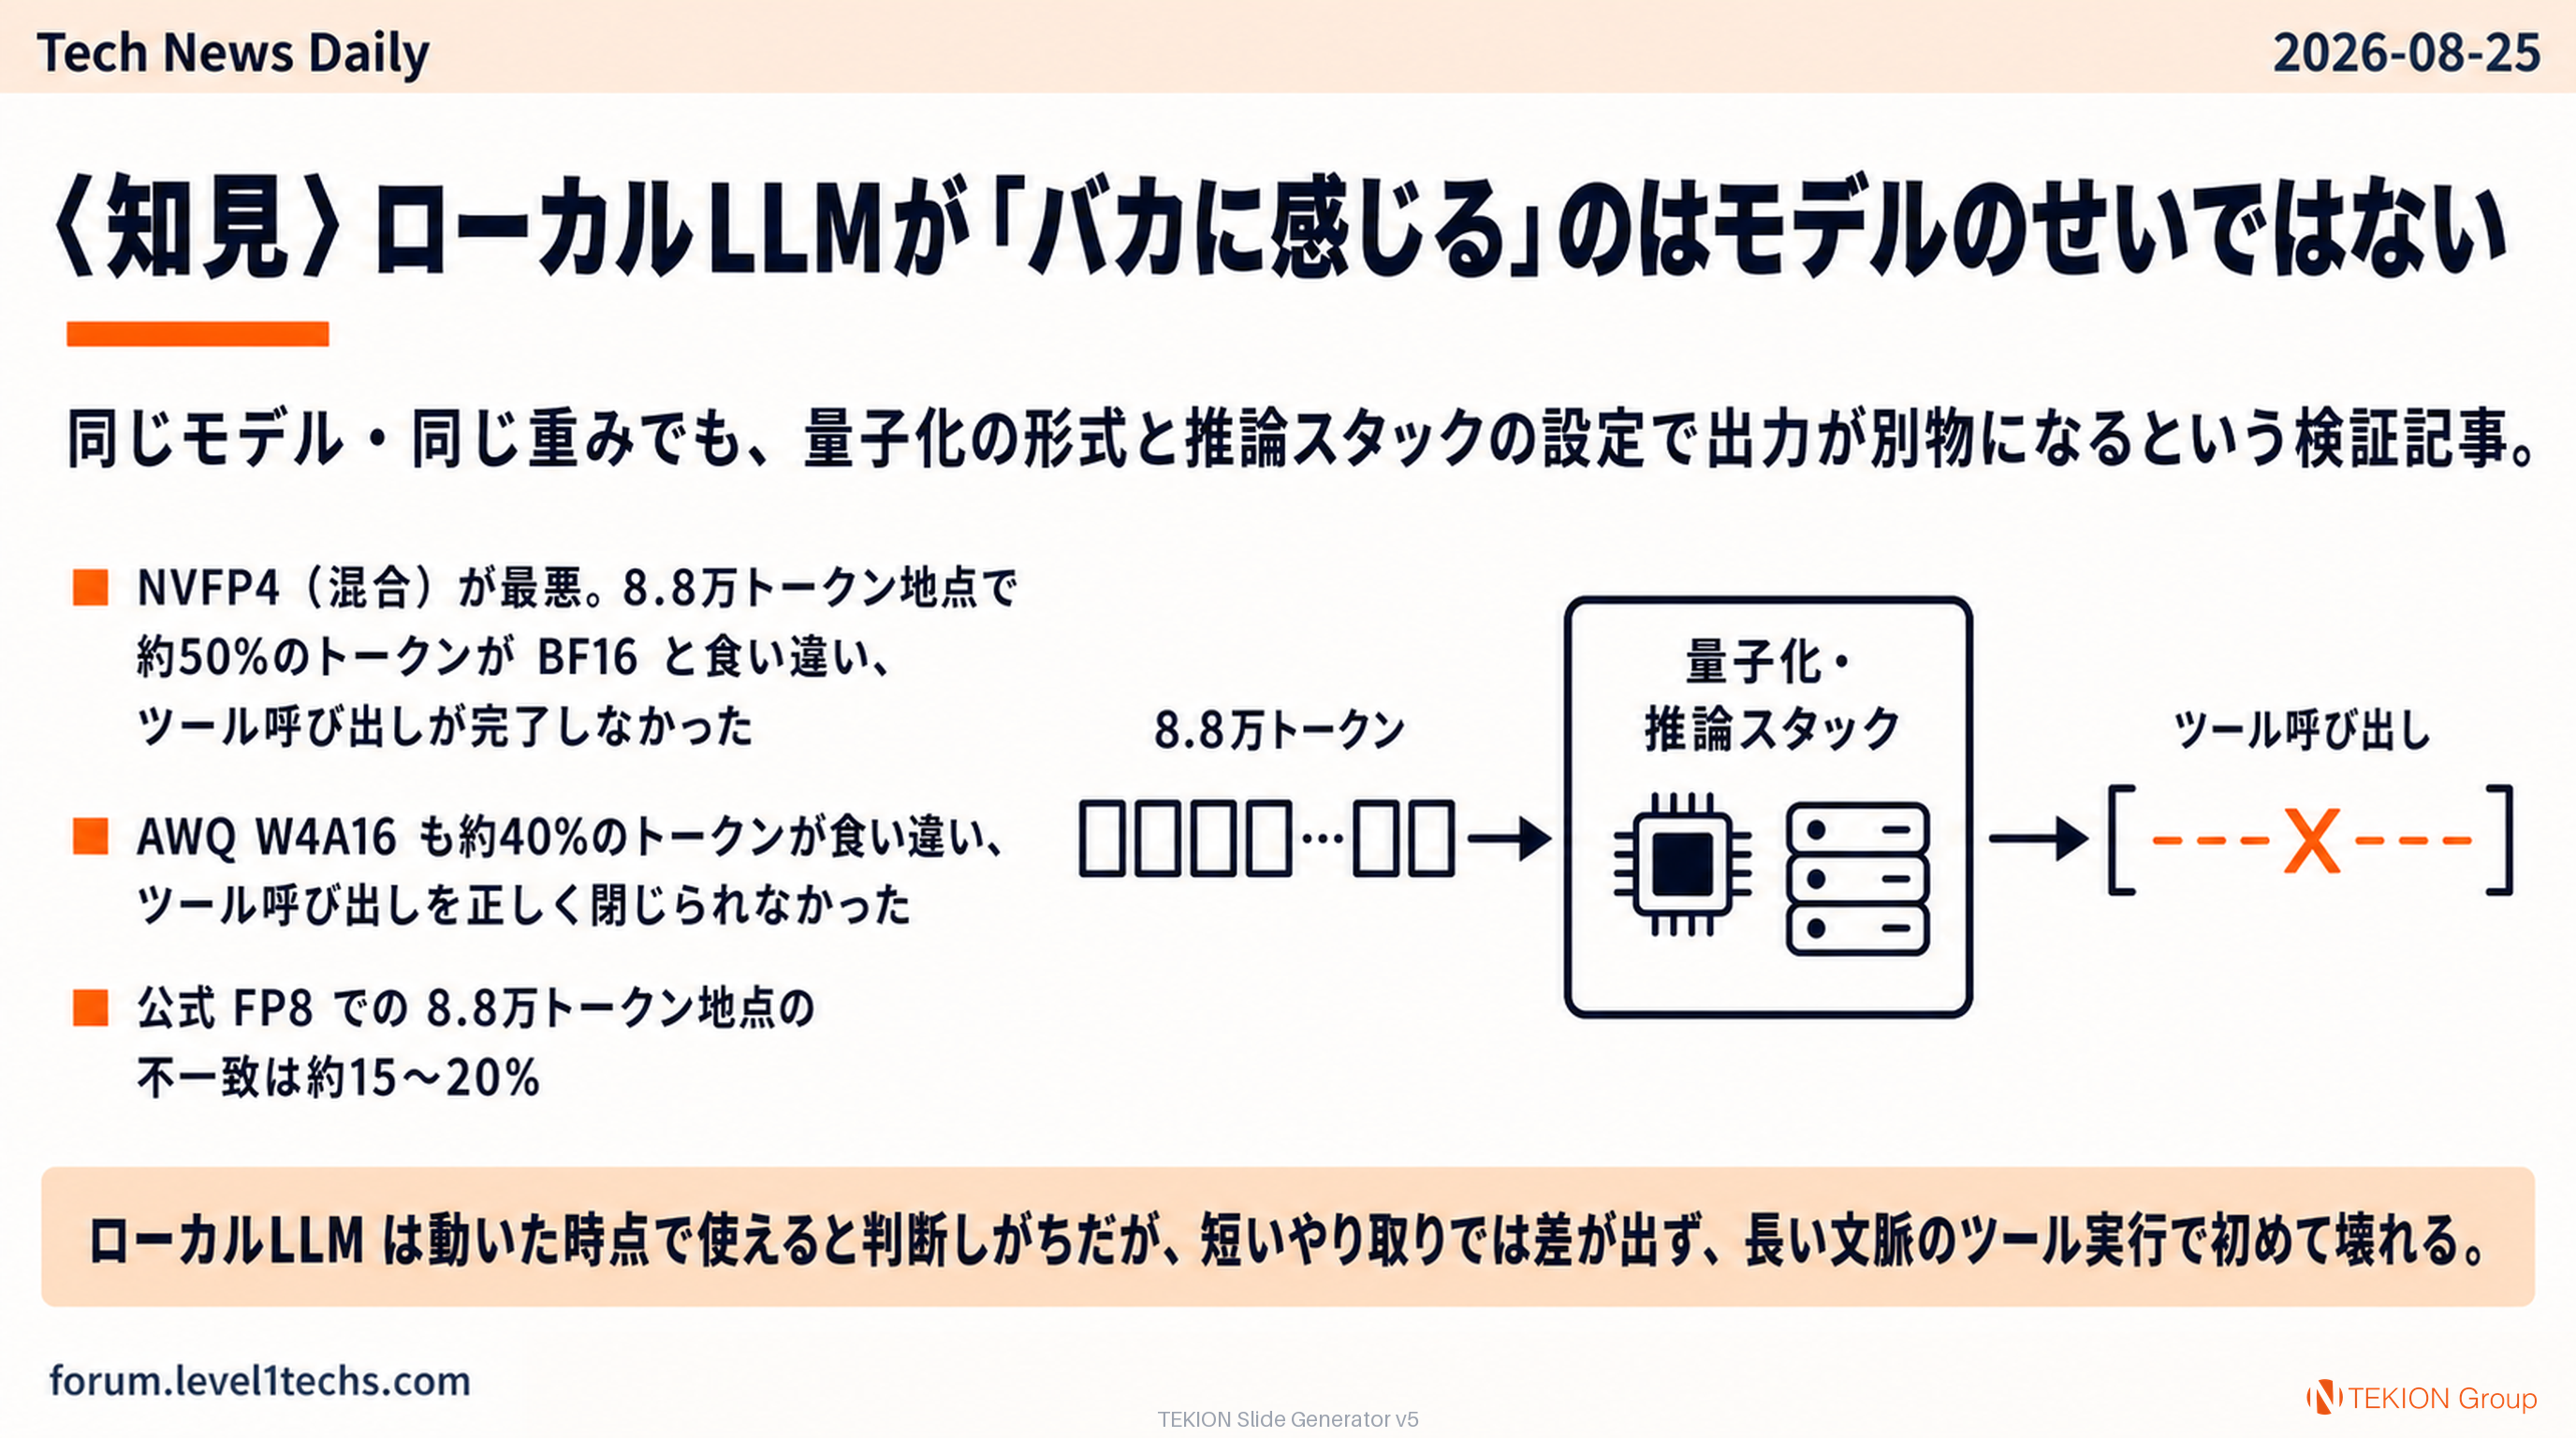
同じモデル・同じ重みでも、量子化の形式と推論スタックの設定で出力が別物になるという検証記事。Qwen 3.6-27B / 3.8-27B に9.6万トークン超の長文タスクを与え、BF16 を基準に各フォーマットのトークン一致率を測っている。結論は「重みの量子化より KV キャッシュの量子化のほうが壊す」「NVFP4 は長い文脈で崩れる」。

キーポイント

  • NVFP4(混合)が最悪。8.8万トークン地点で約50%のトークンが BF16 と食い違い、ツール呼び出しが完了しなかった
  • AWQ W4A16 も約40%のトークンが食い違い、ツール呼び出しを正しく閉じられなかった
  • 公式 FP8 での 8.8万トークン地点の不一致は約15〜20%
  • INT8 W8A16 が最良。劣化はごくわずかで、ツール呼び出しも完走した
  • KV キャッシュを INT4 にするとツール呼び出し中にトークンが飛んで失敗。INT8 なら復帰、BF16 なら正しいまま
  • 壊れ方の実例: インターフェース名が GigabitEthernet0/0/1.201 → 0/1/4 に化ける、show mac address table を打つべき場面で show run を打つ
  • テンソル並列の設定でも結果が変わる。TP2 で失敗したタスクが TP1・TP4 では成功した
ローカルLLM は動いた時点で使えると判断しがちだが、短いやり取りでは差が出ず、長い文脈のツール実行で初めて壊れる。エージェントに長時間の作業を任せるなら量子化の選択がそのまま失敗率になる。手元で動かすなら INT8 系を基準に、KV キャッシュは削らないのが安全側。
AI×ビジネス活用 / タイミー AI/データ部門 / SPEAKER DECK / NEWS

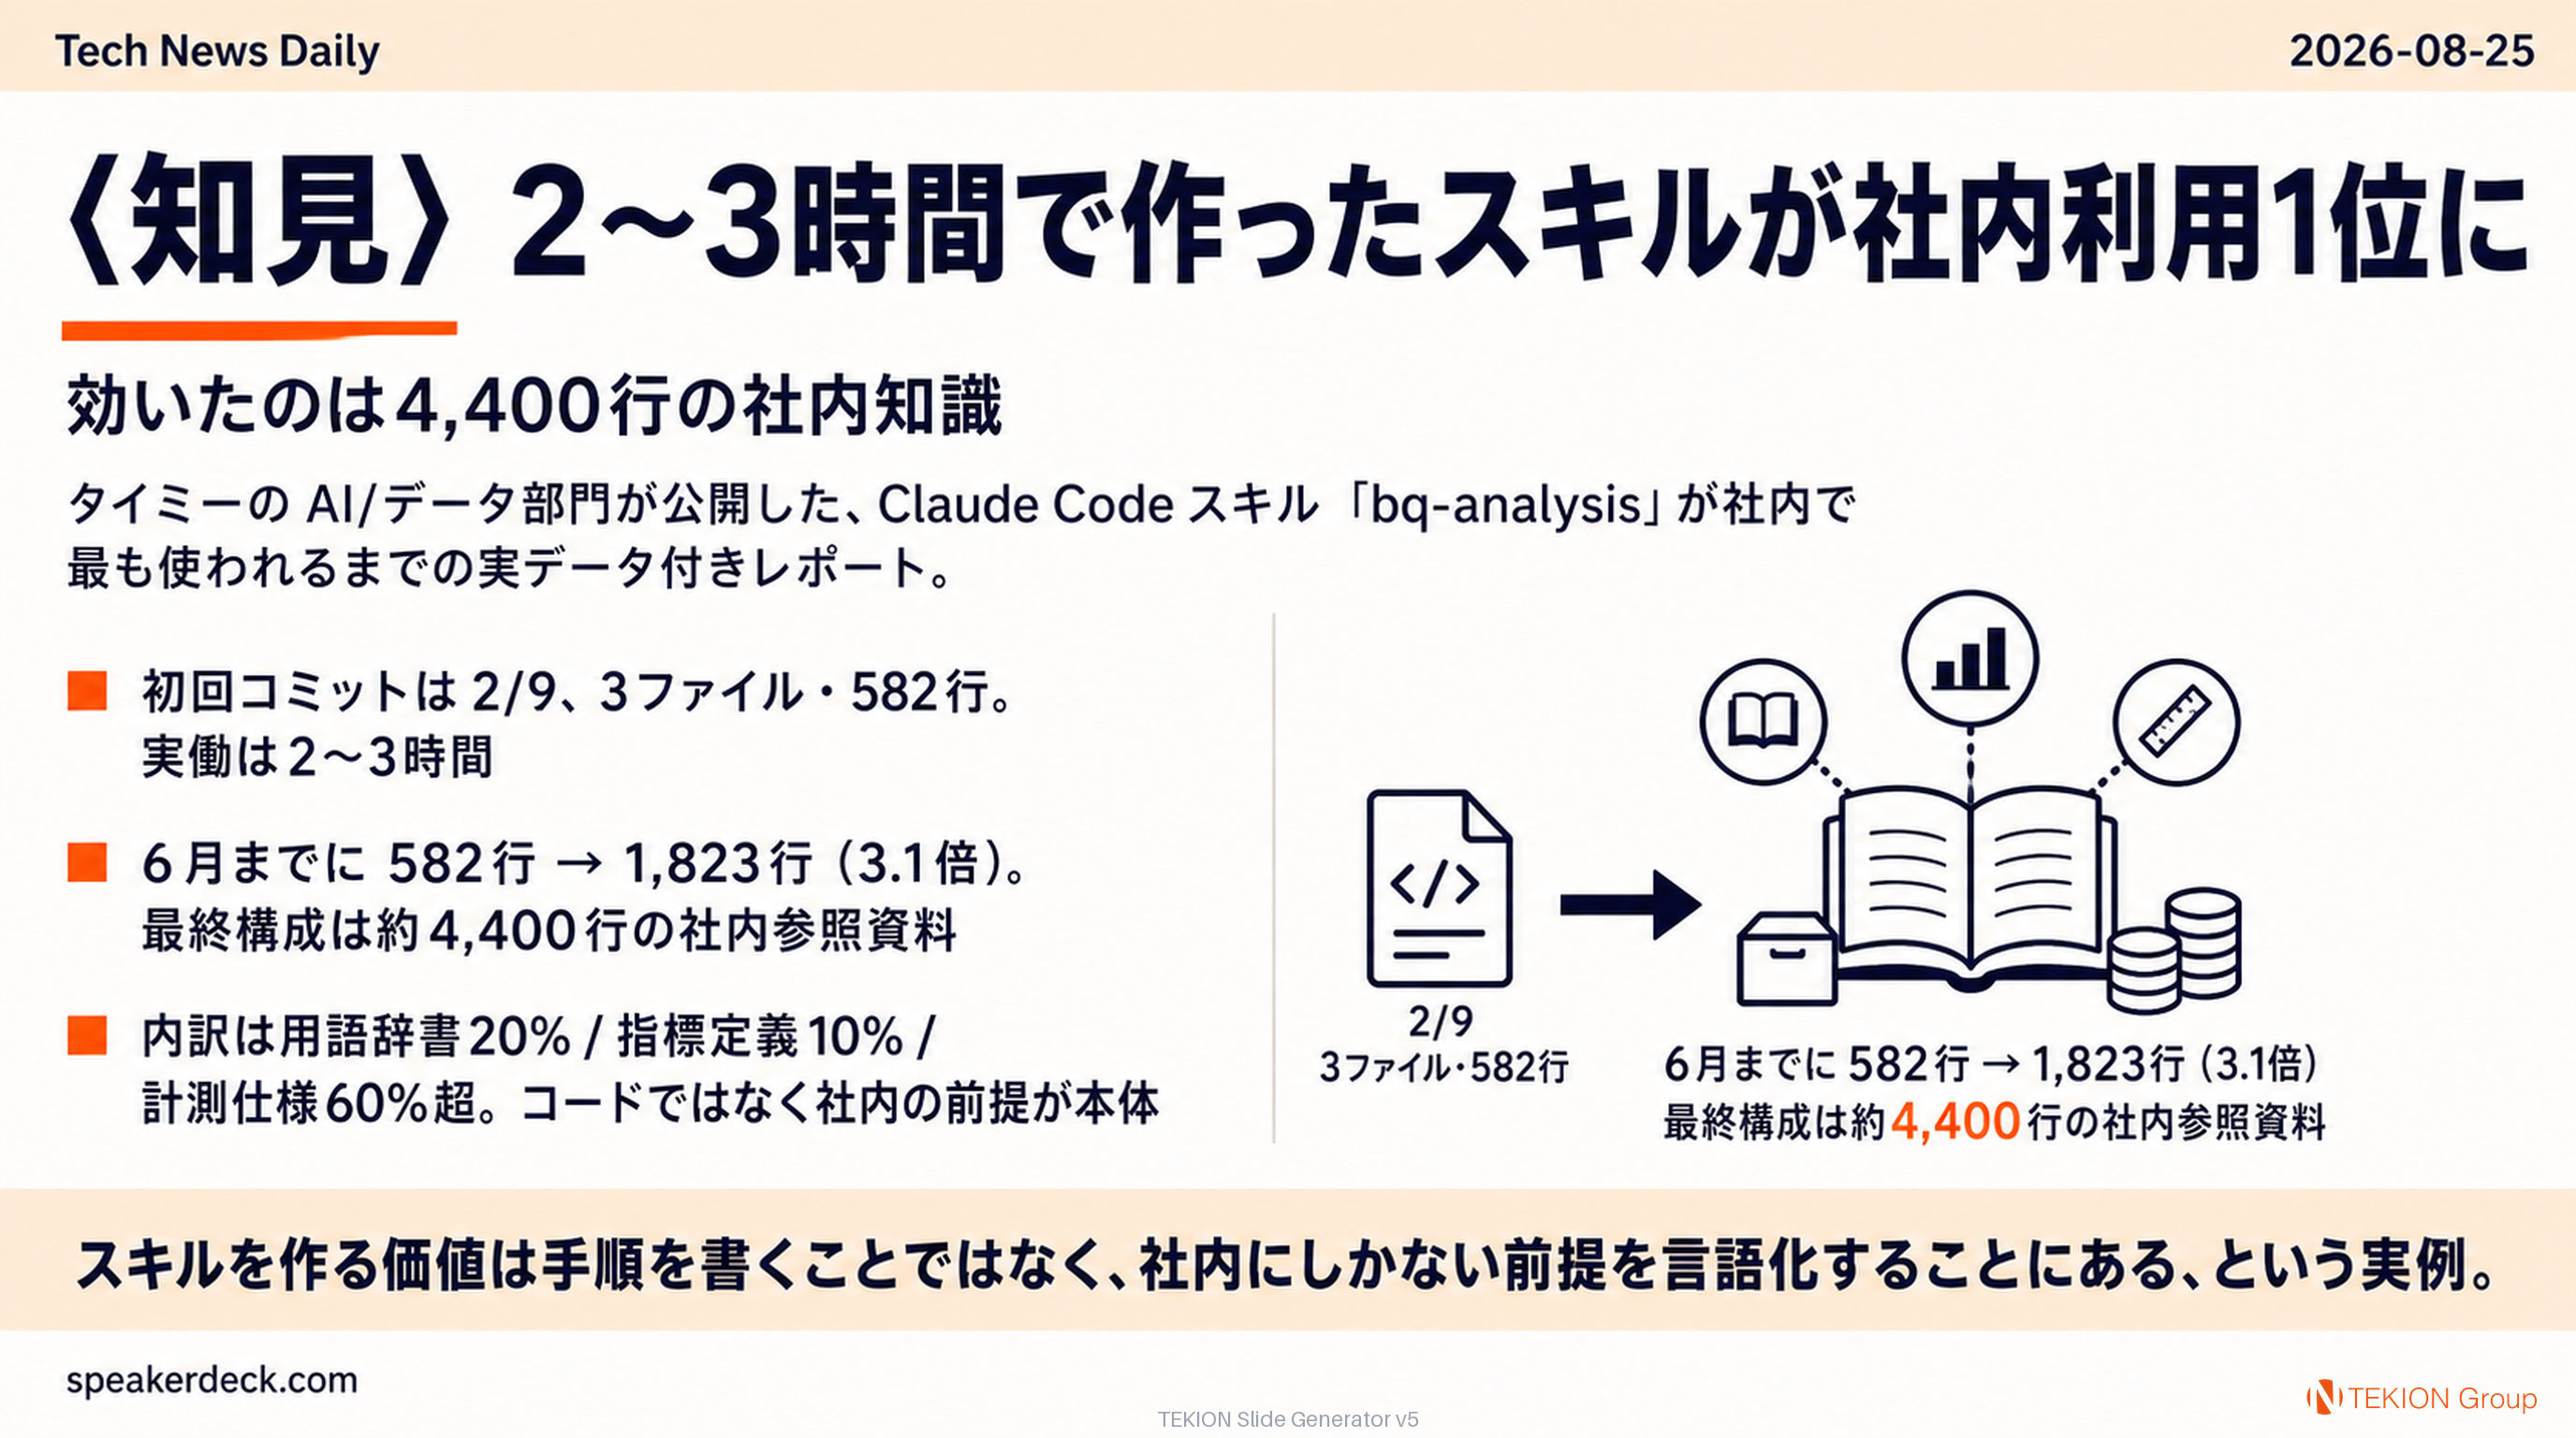
〈知見〉2〜3時間で作ったスキルが社内利用1位に — 効いたのは4,400行の社内知識

〈知見〉2〜3時間で作ったスキルが社内利用1位に — 効いたのは4,400行の社内知識

タイミーの AI/データ部門が公開した、Claude Code スキル「bq-analysis」が社内で最も使われるまでの実データ付きレポート。作った本人の実働は2〜3時間だが、その後4か月かけて社内用語・指標定義・計測仕様を書き足し続け、最終的に約4,400行の参照資料を伴うスキルになった。使う人の主役はエンジニアではなく、SQL を書かない PdM だった。

キーポイント

  • 初回コミットは 2/9、3ファイル・582行。実働は2〜3時間
  • 6月までに 582行 → 1,823行(3.1倍)。最終構成は約4,400行の社内参照資料
  • 内訳は用語辞書20% / 指標定義10% / 計測仕様60%超。コードではなく社内の前提が本体
  • 58日間・Claude Code 利用者約200名での到達率は PdM 65% / データアナリスト45% / エンジニア36%
  • 週1日以上使う割合は PdM 77%(利用日数の中央値10日)、アナリスト40%(中央値5日)、エンジニア41%(中央値4日)
  • リポジトリの29コミットのうち作者本人は9コミット(31%)。残りは利用者側からの改善
  • 別集計では利用回数1,546回で全ジャンル中トップ
スキルを作る価値は手順を書くことではなく、社内にしかない前提を言語化することにある、という実例。作る時間は2〜3時間でも、効いたのは4か月分の知識の積み上げだった。同じことをやるなら最初に書くべきは処理手順ではなく用語と指標の定義になる。
セキュリティ / ベク (@BEKU_AI) / X ARTICLE / BOOKMARK

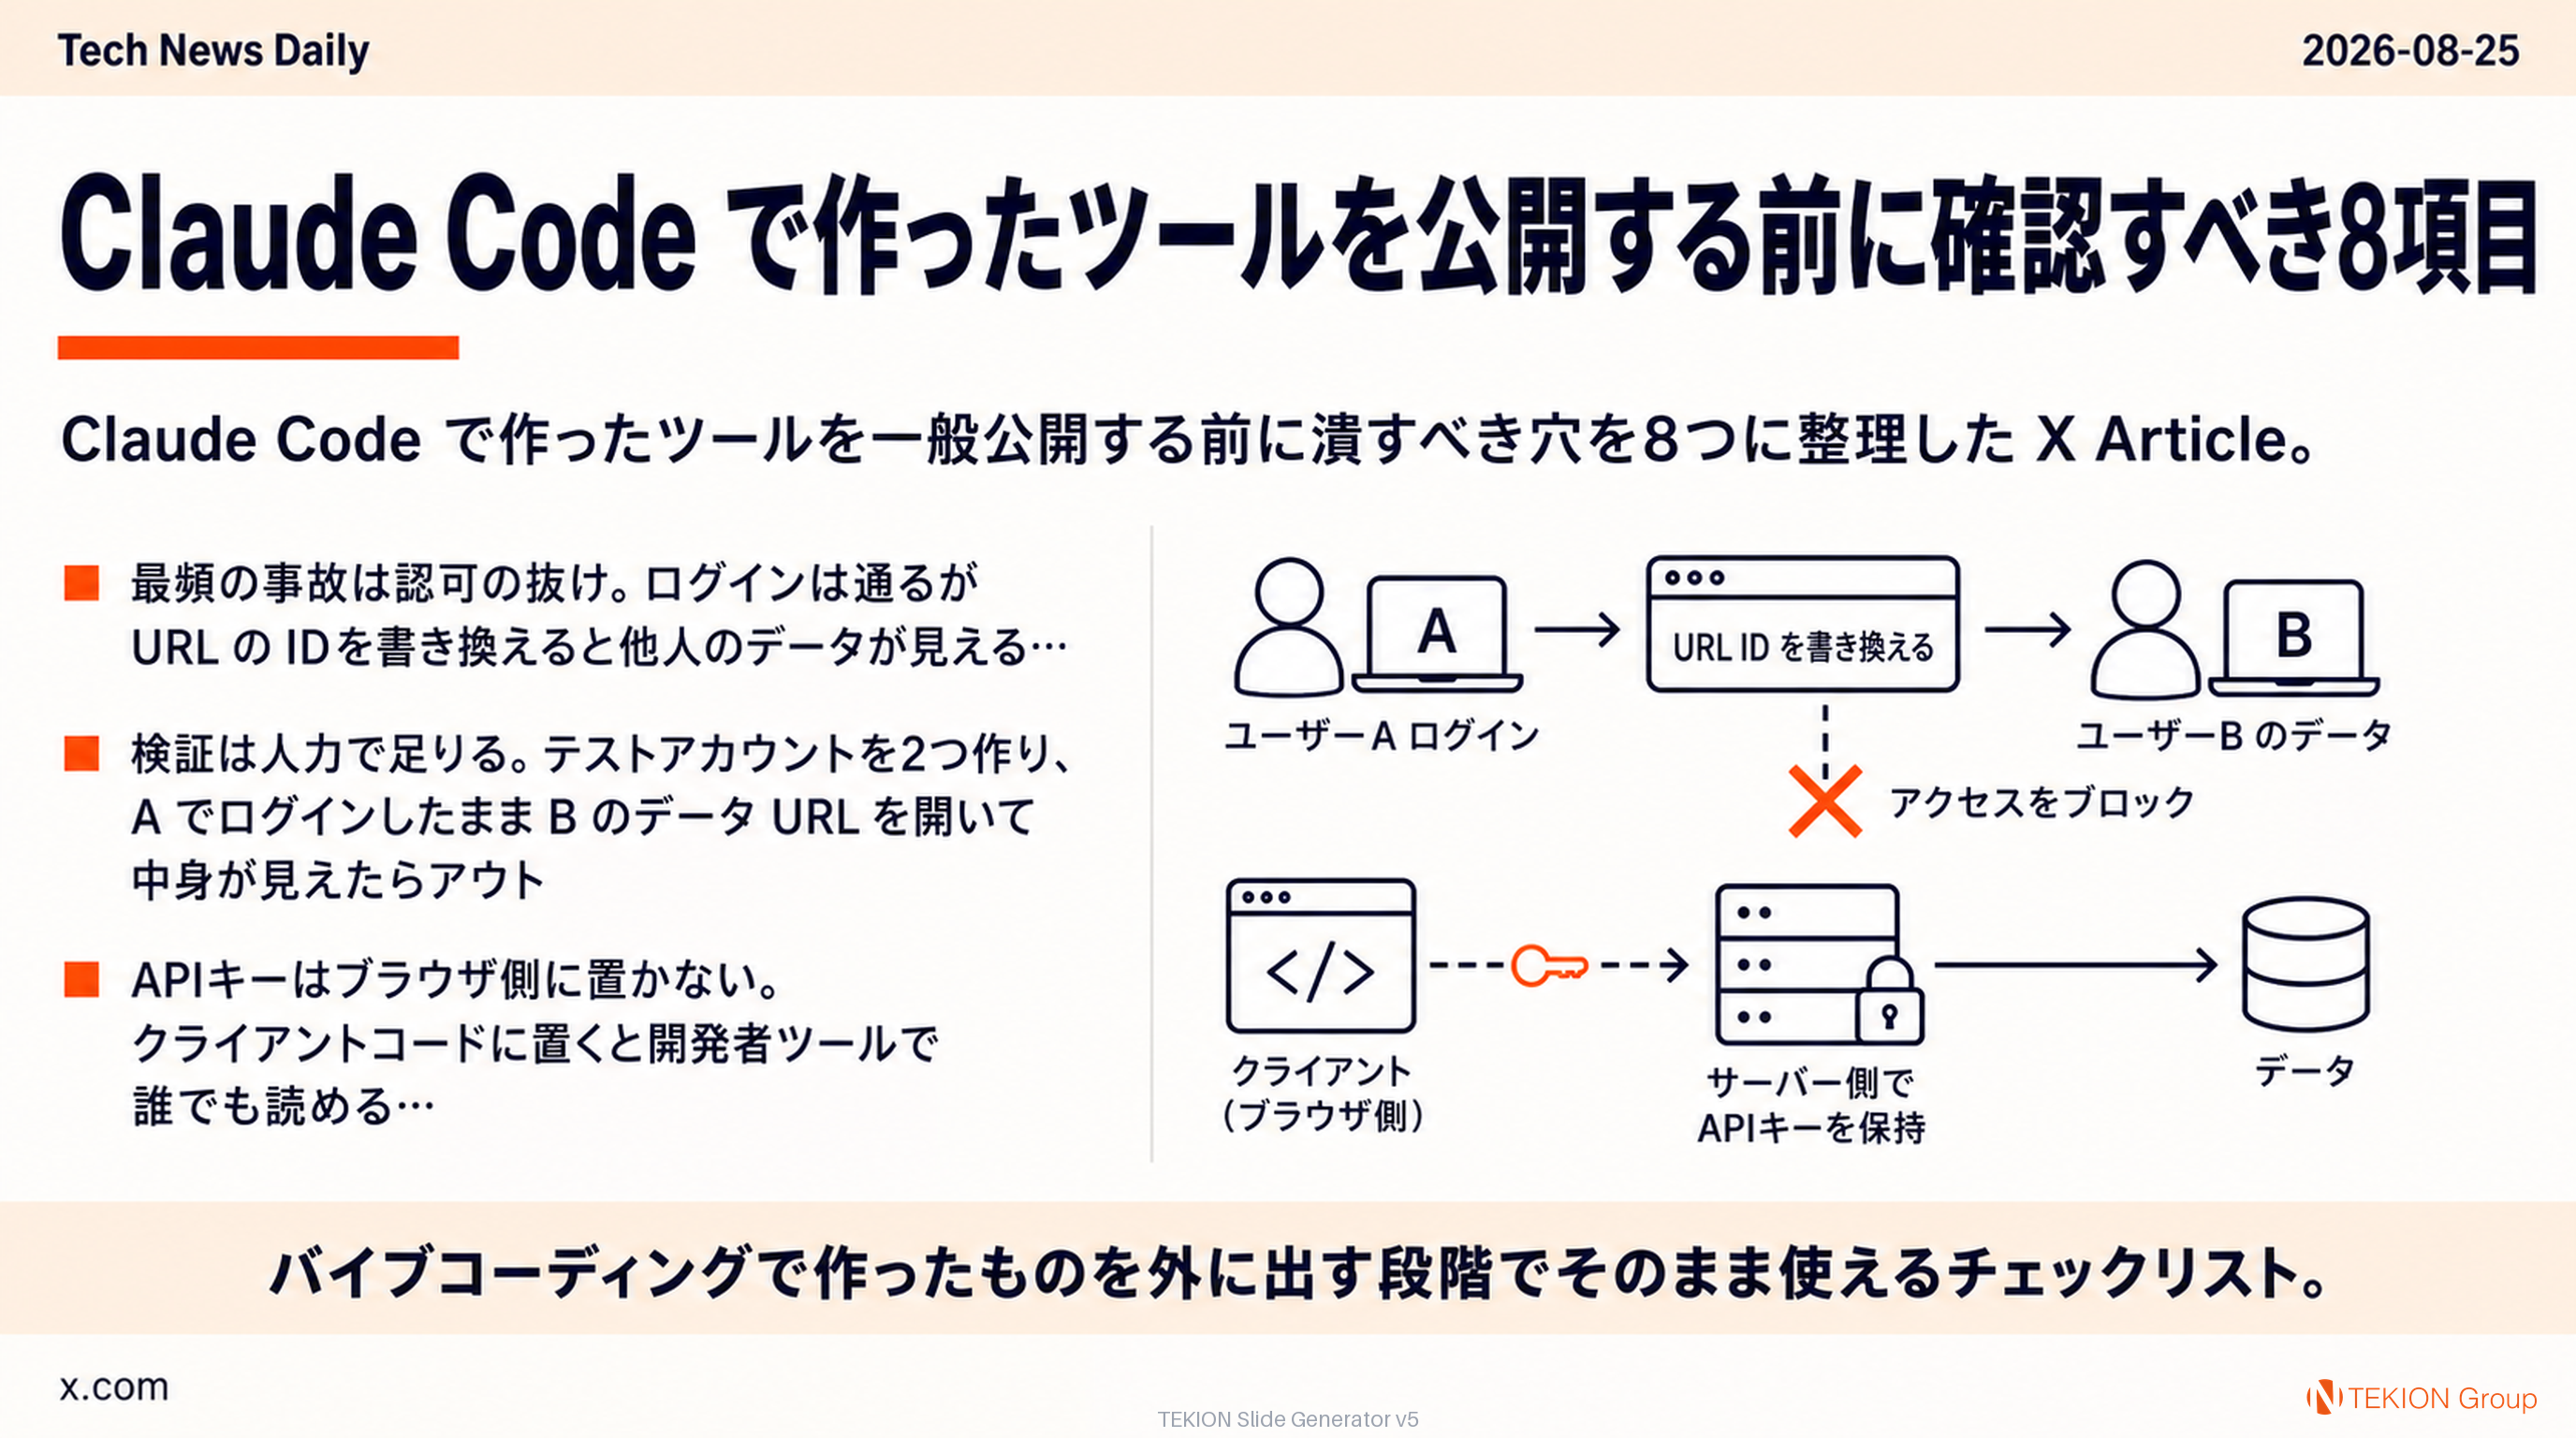
Claude Code で作ったツールを公開する前に確認すべき8項目

Claude Code で作ったツールを公開する前に確認すべき8項目

Claude Code で作ったツールを一般公開する前に潰すべき穴を8つに整理した X Article。認可漏れ・APIキーのクライアント直書き・古い依存ライブラリ・入力欄とURLパラメータの無防備さ・プロンプトインジェクション・課金の青天井・ログ不在・公開後の放置、という順で並ぶ。各項目に Claude Code へそのまま投げる確認プロンプトと、自分で試せる検証手順が付いている。

キーポイント

  • 最頻の事故は認可の抜け。ログインは通るが URL の ID を書き換えると他人のデータが見える。指示を「ログイン機能を付けて」で止めず「ユーザーは自分のデータにしかアクセスできないようにして」まで書く
  • 検証は人力で足りる。テストアカウントを2つ作り、A でログインしたまま B のデータ URL を開いて中身が見えたらアウト
  • APIキーはブラウザ側に置かない。クライアントコードに置くと開発者ツールで誰でも読める。漏れたキーは無効化して作り直すまでが対応
  • AI は学習データの都合でサポート終了済みライブラリを平気で選ぶ。npm audit を流して脆弱性0件を確認してから公開する
  • AI を組み込んだツールは、①渡す情報を最小化 ②ユーザー入力は指示ではなく処理対象データとして渡す ③監査させる の3点が最低ライン
  • 課金の青天井が金銭的インパクト最大。ツール側の回数制限+プロバイダ管理画面の月次上限額を公開前に設定する
  • 公開した日が一番安全。Dependabot(GitHub 無料・プライベートリポジトリでも可)を ON にして、アラートが来たら Claude Code に直させる
  • 開発に使ったのとは別の AI に同じ監査プロンプトを流すと、別の穴が出てくる
バイブコーディングで作ったものを外に出す段階でそのまま使えるチェックリスト。認可・APIキー・課金上限の3つは、公開したときに実際に事故が起きる箇所。
📄 PDFをダウンロード 🧵 X スレッドで読む